
VLA・模倣学習開発書き下ろせない動作を、人の実演から学ばせる。
対象物の形や位置が毎回変わる作業は、動作をプログラムで書き下ろすのが困難です。人の実演から動作を学習させる模倣学習と、視覚・言語の理解を動作生成につなぐVLAの実装に取り組んでいます。
VLA・模倣学習を相談する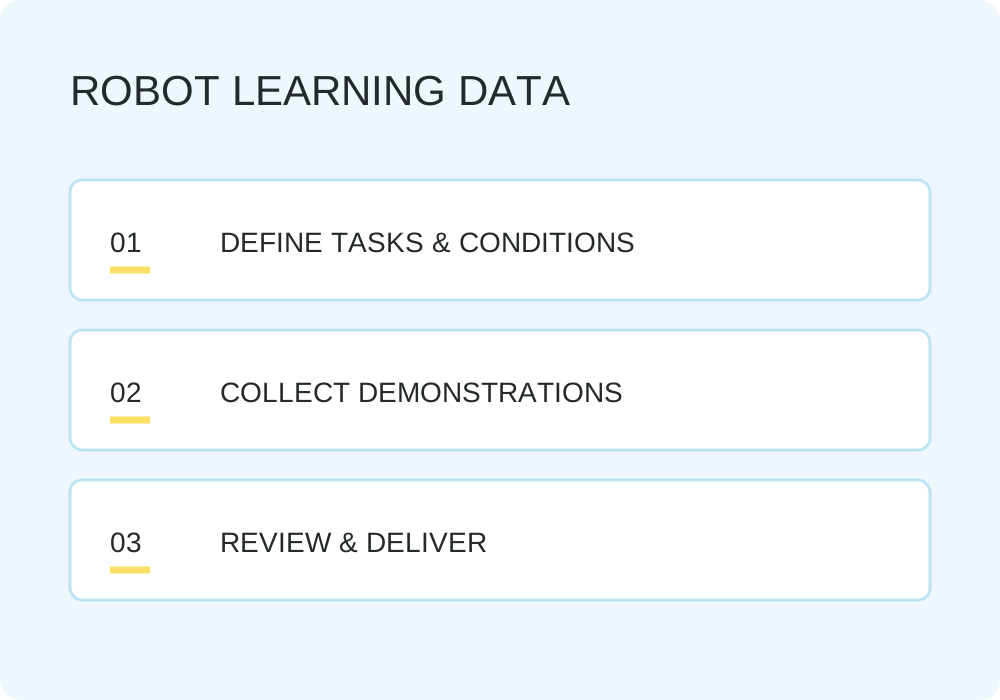
工場・倉庫の搬送シミュレーション
Unitree G1
Isaac Sim内の物理シミュレーションで、0.25 kgの箱を両手で保持し、約1.2 m歩いて別の台へ置く動作を検証しました。実機の映像ではありません。
RealMan RMC-AIDAL
本体30×20×20 cm・総重量10 kgの想定搬送ケースのハンドルを把持し、約1.2 mの車輪走行で搬送して台へ置き、手を離すまでを検証しました。公開CADモデルの重心・接触設定を補正した物理シミュレーションで、実機の耐荷重を保証するものではありません。
RealMan RMC-AIDAL:両腕での10 kgケース搬送
本体30×40×20 cm・総重量10 kgの想定搬送ケースを、左右のハンドルで両手把持し、約1.2 m搬送して台へ置く動作を検証しました。搬送中は左右両手の接触と荷重分担を記録しています。公開CADモデルの重心・接触設定を補正した物理シミュレーションで、実機の耐荷重を保証するものではありません。
棚への補充、部品箱の供給、仕分けなど、対象業務に合わせたシミュレーション・実証実験もご相談いただけます。
環境・箱の3D素材: NVIDIA SimReady / codepawl/simready-glb · CC BY 4.0 · 素材の変換・寸法・表示材質を調整しています。
プログラムで書けない作業がある
決まった位置の決まった物を掴むなら、動作を書き下ろすほうが確実で速いです。学習を持ち出す意味があるのは、書き下ろせない作業のときだけです。
対象物の形が個体ごとに違う、置かれ方が毎回変わる、袋や布のように変形する。こうした作業は条件分岐を書き切れません。人の実演を見せて動作を獲得させるアプローチが現実的になります。
一方で、学習は万能ではありません。必要なデータ量は作業の難易度と要求する成功率で変わり、集めてみるまで読み切れない部分があります。試験収集で見極めてから本収集に進む進め方をとっています。
実装例:Gemini 4 Argon × Unitree G1(視覚から行動への変換)
Gemini 4 Argonを用い、Unitree G1がハードコードされた動作を一切使わずにペットボトルを掴んで持ち上げる実機検証に成功しました。AIがカメラの視覚情報を直接ロボットのアクションへと変換し、対象物の位置を変えて置き直しても状況に応じて把持動作を生成します。
こうした基盤モデル・VLAを用いた視覚からの行動生成と、人の実演データに基づく模倣学習を、対象機体や現場の作業条件に合わせて設計・実装します。
お引き受けできる範囲
対象作業の切り分け
学習で解くべき部分と、書き下ろしたほうが速い部分を分けます。全部を学習させる必要はありません。
実演データの収集設計
何を、どの視点から、どれだけ記録するか。対象作業・機体・品質基準を設計します。
遠隔操作による実演
操作者の身体動作をロボットへ転写し、実機で作業させながらデータを集めます。運用と収集を同時に進められます。
模倣学習の実装
収集したデータから動作を学習させ、成功率を評価します。ROS 2 / LeRobotを基盤に実装します。
VLAの実装
視覚と言語の理解を動作生成につなぎます。言葉による指示と目の前の状況から次の動作を決める構成です。
実機での評価
ベンチマークではなく、対象の現場で成功率とタクトを測ります。条件を変えて成立範囲を特定します。
データがすべての土台になる
学習の成否は、モデルより先にデータで決まります。視点が足りない、失敗例がない、作業条件が揺れている。こうしたデータで学習させても、現場では動きません。
当社では、対象作業・機体・収集量・品質基準を設計したうえで実機からデータを取得します。遠隔操作で実際に作業させながら、視覚・行動・対話・非言語を同期記録する構成も用意しています。
データの収集だけを受託することも、収集環境の構築だけをご相談いただくことも可能です。
NVIDIA GEAR Sonic × Unitree G1:実機での動作検証
Unitree G1の実機でNVIDIA GEAR Sonicを動かし、動作確認を行いました。検証時の様子を動画でご紹介します。
Gemini 4 Argon × Unitree G1:視覚から行動へ変換する自律把持デモ
Gemini 4 Argonを用い、Unitree G1がペットボトルを掴んで持ち上げる実機検証を実施しました。ハードコードされたモーションは一切使わず、AIがカメラの視覚情報をそのまま行動へと変換しています。
対象物の位置を変えて置き直しても、AIが視覚から状況を理解して把持動作を生成します。Unitree G1を用いたフィジカルAI・VLAの実装や、対象業務に合わせたPoC・実証実験の受託開発も承っています。
よくあるご質問
学習データはどのくらい必要ですか?
作業の難易度、環境の変動の大きさ、要求する成功率によって変わります。まず試験収集を行い、必要な量と品質基準を見極めてから本収集に進む方法をとっています。最初から総量を約束することはしません。
データを持っていませんが始められますか?
はい。収集の設計から対応します。遠隔操作で実機に作業させながら記録する構成なら、運用とデータ収集を同時に進められます。
どのロボットで実装できますか?
ROS 2や機体SDKで制御できる機体であればご相談いただけます。二次開発に対応したモデルが扱いやすくなります。対象機体をお知らせください。
VLAと模倣学習の違いは何ですか?
模倣学習は人の実演から動作を獲得させる手法の総称です。VLAは視覚と言語の理解を動作生成につなぐモデルの構成を指し、言葉による指示を扱える点が異なります。対象作業に応じて使い分けます。
VLA・模倣学習のご相談
対象作業と機体、いまお持ちのデータの状況をお知らせください。学習で解くべき範囲の切り分けからご一緒します。
VLA・模倣学習を相談する