
VLA/ تطوير التعلم بالتقليداطلب منهم أن يتعلموا الحركات التي لا يمكن تدوينها من مظاهرات الآخرين.
من الصعب تدوين الحركات في البرنامج عندما يتغير شكل الكائن أو موضعه في كل مرة. نحن نعمل على تنفيذ التعلم بالتقليد، الذي يتعلم الحركات من العروض البشرية، وVLA، الذي يربط الفهم البصري واللغوي بتوليد الحركة.
استشارة حول التعلم VLA/التقليد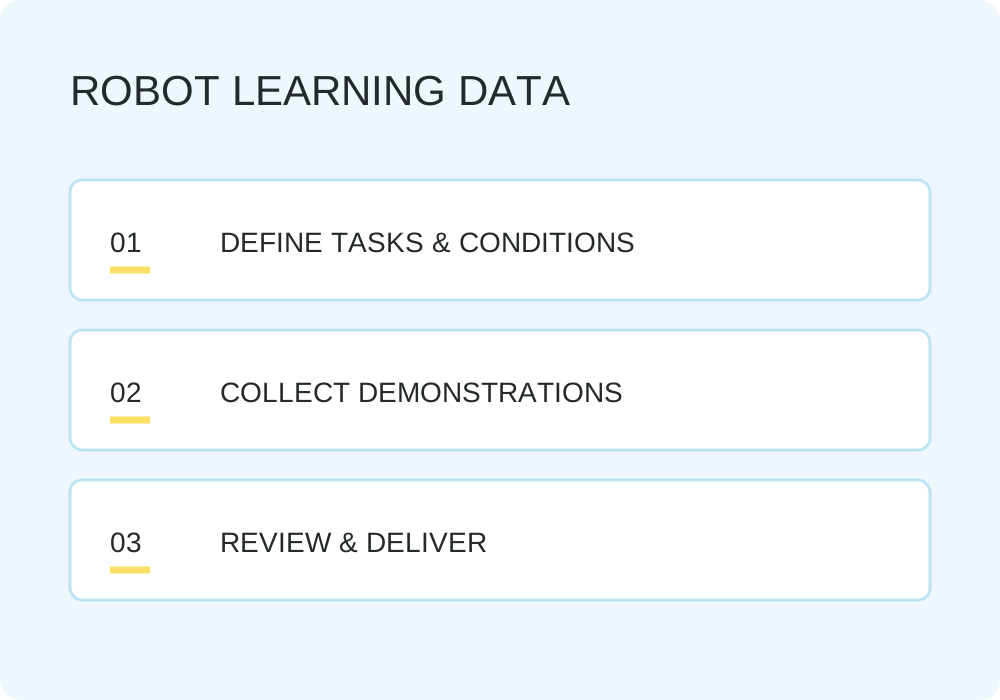
محاكاة نقل المصنع/المستودع
Unitree G1
أثبتت محاكاة فيزيائية أجراها إسحاق سيم سلوك الإمساك بصندوق كتلته 0.25 كجم بكلتا اليدين، والمشي لمسافة 1.2 متر تقريبًا، ووضعه على منصة أخرى. هذا ليس فيديو للجهاز الفعلي
RealMan RMC-AIDAL
أمسكنا بمقبض حقيبة نقل افتراضية بأبعاد 30 × 20 × 20 سم ووزن إجمالي 10 كجم، وتحققنا من عملية نقلها على عجلات لمسافة 1.2 متر تقريبًا، ووضعناها على حامل، ثم أطلقناها. هذه محاكاة فيزيائية تعمل على تصحيح مركز الجاذبية وإعدادات الاتصال لنموذج CAD العام، ولا تضمن سعة التحميل للجهاز الفعلي.
RealMan RMC-AIDAL: حقيبة نقل بوزن 10 كجم بكلا الذراعين
لقد تحققنا من عملية حمل حقيبة نقل افتراضية بحجم جسم 30 × 40 × 20 سم ووزن إجمالي 10 كجم بكلتا اليدين باستخدام المقبضين الأيسر والأيمن، ونقلها حوالي 1.2 متر، ووضعها على حامل. أثناء النقل، يتم تسجيل الاتصال بين اليد اليسرى واليمنى ومشاركة الحمل. هذه محاكاة فيزيائية تعمل على تصحيح مركز الجاذبية وإعدادات الاتصال لنموذج CAD العام، ولا تضمن سعة التحميل للجهاز الفعلي.
يمكنك أيضًا استشارة معنا حول عمليات المحاكاة والتجارب التوضيحية المصممة خصيصًا لشركتك، مثل تجديد الرفوف وتوريد صناديق قطع الغيار والفرز.
البيئة / مواد الصندوق ثلاثية الأبعاد: NVIDIA SimReady / codepawl/simready-glb · CC BY 4.0 · نقوم بتعديل تحويل المواد والأبعاد ومواد العرض.
هناك مهام لا يمكن كتابتها باستخدام برنامج.
إذا كنت تريد الإمساك بجسم ثابت في وضع ثابت، فمن الآمن والأسرع كتابة الحركة. المرة الوحيدة التي يكون من المنطقي فيها الحديث عن التعلم هي عندما يكون لديك مهمة لا يمكنك كتابتها.
يختلف شكل كل كائن، وتتغير طريقة وضعه في كل مرة، ويتشوه مثل الكيس أو القماش. هذا النوع من العمل لا يمكنه كتابة فروع مشروطة. النهج الأكثر واقعية هو أن نوضح للناس كيفية أداء الحركات وجعلهم يتعلمون الحركات.
ومن ناحية أخرى، فإن التعلم ليس مقاسًا واحدًا يناسب الجميع. تختلف كمية البيانات المطلوبة حسب صعوبة المهمة ونسبة النجاح المطلوبة، وهناك بعض الأجزاء التي لا يمكن قراءتها بالكامل حتى تقوم بجمعها. نهجنا هو تحديد الجودة من خلال جمع الاختبار ومن ثم الانتقال إلى التجميع الفعلي.
مثال التنفيذ: Gemini 4 Argon × Unitree G1 (التحويل من الرؤية إلى السلوك)
باستخدام Gemini 4 Argon، نجحنا في التحقق من أن Unitree G1 يمسك ويرفع زجاجة بلاستيكية دون استخدام أي حركات مشفرة. يقوم الذكاء الاصطناعي بتحويل المعلومات المرئية للكاميرا مباشرة إلى إجراءات روبوتية، ويولد حركات الإمساك اعتمادًا على الموقف، حتى لو تم تغيير موضع الكائن وتغيير موضعه.
سنقوم بتصميم وتنفيذ إنشاء الإجراء المرئي باستخدام هذا النموذج الأساسي، VLA، والتعلم بالتقليد استنادًا إلى بيانات الأداء البشري، المصممة خصيصًا للهدف الروبوت وظروف العمل في الموقع.
النطاق الذي يمكن قبوله
عزل العمل المستهدف
افصل بين الأجزاء التي ينبغي حلها عن طريق الدراسة والأجزاء التي تكون أسرع في الكتابة. لا تحتاج إلى تعلم كل شيء.
مظاهرة تصميم جمع البيانات
ما الذي يجب تسجيله، ومن أي منظور، وكم؟ تصميم العمل المستهدف، الروبوت، ومعايير الجودة.
مظاهرة عن طريق التحكم عن بعد
يتم نقل الحركات الجسدية للمشغل إلى الروبوت، ويتم جمع البيانات أثناء عمل الروبوت على الجهاز الفعلي. يمكنك متابعة التشغيل والتحصيل في نفس الوقت.
تنفيذ التعلم بالتقليد
يتعلم السلوك من البيانات المجمعة ويقيم معدل النجاح. تم التنفيذ بناءً على ROS 2/LeRobot.
تنفيذ VLA
ربط الفهم البصري واللغوي بتوليد العمل. يتضمن هذا الهيكل تحديد الإجراء التالي بناءً على التعليمات الشفهية والموقف الذي أمامك.
التقييم على الجهاز الفعلي
نحن نقيس معدل النجاح ووقت العمل في الموقع المستهدف، بدلاً من استخدام المعايير. حدد نطاق الصلاحية عن طريق تغيير الشروط.
البيانات هي أساس كل شيء
يتم تحديد نجاح أو فشل التعلم من خلال البيانات الموجودة قبل النموذج. هناك نقص في المنظور، ولا توجد أمثلة على الفشل، وظروف العمل غير مستقرة. وحتى لو قمت بتدريبه باستخدام هذه البيانات، فلن ينجح في الميدان.
في شركتنا، نحصل على البيانات من المعدات الفعلية بعد تصميم العمل المستهدف، الروبوت، كمية التحصيل، ومعايير الجودة. لدينا أيضًا تكوين يسمح لك بتسجيل المعلومات المرئية والسلوكية والحوارية وغير اللفظية بشكل متزامن أثناء العمل عن بعد.
من الممكن أن نعهد فقط بجمع البيانات، أو التشاور فقط بشأن بناء بيئة التجميع.
NVIDIA GEAR Sonic × Unitree G1: التحقق من العملية على الجهاز الفعلي
قمنا بتشغيل NVIDIA GEAR Sonic على Unitree G1 الفعلي وأكدنا تشغيله. هنا فيديو لعملية التحقق.
Gemini 4 Argon × Unitree G1: عرض الإمساك المستقل الذي يحول الرؤية إلى عمل
باستخدام Gemini 4 Argon، أجرينا اختبارًا فعليًا للآلة حيث قام Unitree G1 بإمساك زجاجة بلاستيكية ورفعها. لا يتم استخدام أي حركة مشفرة؛ يقوم الذكاء الاصطناعي بتحويل المعلومات المرئية للكاميرا مباشرة إلى إجراءات.
حتى إذا قمت بتغيير موضع الكائن ووضعه مرة أخرى، فسوف يفهم الذكاء الاصطناعي الموقف بصريًا ويولد حركة استيعاب. نحن نقبل أيضًا تنفيذ الذكاء الاصطناعي/VLA المادي باستخدام Unitree G1 وتطوير العقود لتجارب إثبات المفهوم/العرض التوضيحي المصممة خصيصًا للأعمال المستهدفة.
الأسئلة المتداولة
ما مقدار بيانات التدريب التي أحتاجها؟
ويختلف حسب صعوبة المهمة، ودرجة التباين في البيئة، ونسبة النجاح المطلوبة. نقوم أولاً بإجراء جمع الاختبار، وتحديد الكمية ومعايير الجودة المطلوبة، ومن ثم الانتقال إلى التجميع الرئيسي. نحن لا نعد المبلغ الإجمالي من البداية.
ليس لدي البيانات، هل يمكنني البدء؟
نعم. نحن نتعامل مع كل شيء بدءًا من تصميم المجموعة. إذا كان لديك تكوين يمكنك من خلاله التحكم عن بعد في الجهاز الفعلي أثناء تسجيله، فيمكنك متابعة العمليات وجمع البيانات في نفس الوقت.
أي روبوت يمكنه تنفيذ ذلك؟
إذا كان من الممكن التحكم في الروبوت باستخدام ROS 2 أو الروبوتSDK، فيمكننا التشاور معك. النماذج المتوافقة مع التطوير الثانوي أسهل في التعامل معها. يرجى إعلامنا بالهدف الروبوت.
ما الفرق بين VLA والتعلم بالتقليد؟
التعلم بالتقليد هو مصطلح عام لطرق اكتساب الحركات من الأداء البشري. يشير VLA إلى تكوين النموذج الذي يربط الفهم البصري واللغوي بتوليد العمل، ويختلف في أنه يمكنه التعامل مع التعليمات اللفظية. استخدامها اعتمادا على العمل المستهدف.
VLA/استشارة التعلم التقليد
يرجى إعلامنا بالعمل المستهدف، الروبوت، وحالة البيانات المتوفرة لديك حاليًا. سنعمل معك لتحديد نطاق الدراسة التي يجب حلها.
استشارة حول التعلم VLA/التقليد